Malva je nova platforma koja omogućava pretragu RNA sekvenci kroz milione pojedinačnih ćelija bez preuzimanja sirovih podataka ili upotrebe referentnog genoma. Indeks pokriva >140 TB podataka i preko 100 milijardi jedinstvenih 24-nt sekvenci iz ~51M ljudskih i ~10M mišjih ćelija. Sistem brzo pretražuje k-mere (~70 ms po k-meru) i može da otkrije mutacije, RNA izoforme, virusne i bakterijske sekvence; dostupan je akademskoj zajednici preko javnog interfejsa i API-ja.
Malva: «Google» Za Ćelijske RNA — Pretražuje Milione Ćelija Za Sekunde
Malva searches RNA across millions of cells in seconds, exposing mutations, pathogens and isoforms hidden in massive biological datasets. (CREDIT: Wikimedia / AI-Generated / CC BY-SA 4.0)
Malva je nova pretraga zasnovana na sekvencama koja istraživačima omogućava da u roku od nekoliko sekundi pronađu specifične RNA signale u milionima pojedinačnih ćelija — bez preuzimanja sirovih podataka ili potrebe za referentnim genomom.
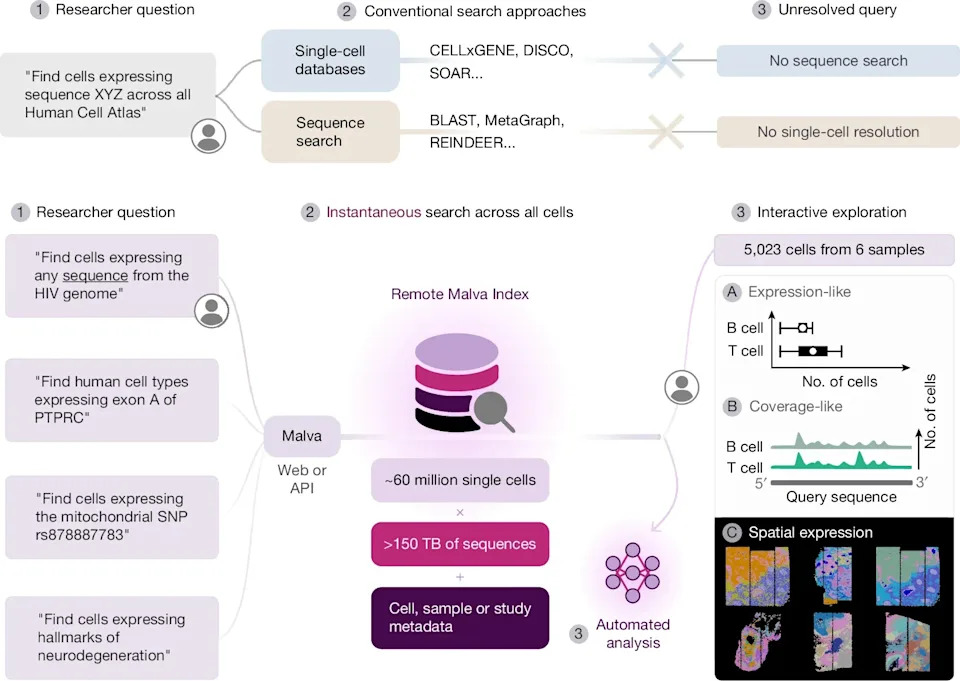
Malva enables instantaneous sequence-based queries across single-cell atlases. (CREDIT: Nikolaus Rajewsky et al, Nature)
Šta je Malva?
Tim iz Berlin Institute of Medical Systems Biology pri Max Delbrück Center opisao je sistem u časopisu Nature. Ko-prvi autori su Daniel León-Periñán i Nikos Karaiskos, dok je Nikolaus Rajewsky glavni autor. Malva indeksira sekvence iz javnih skupova podataka i omogućava direktne pretrage ćelija po kratkim RNA segmentima (k-merima).
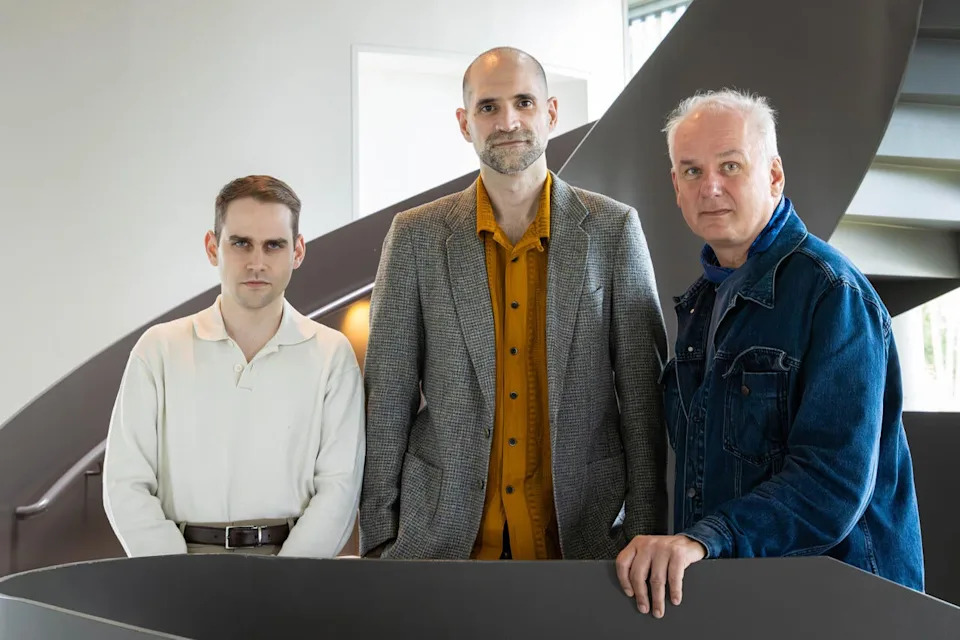
Daniel León-Periñán, Nikos Karaiskos, Nikolaus Rajewsky, creators of Malva. (CREDIT: Felix Petermann, Max Delbrück Center)
Kako radi
Umesto ponovnog poravnavanja (alignment) velikih sirovih datoteka prema referentnom genomu, Malva deli čitanja u kratke segmente (k-mere) i beleži u kojim su ćelijama pronađeni. Korisnik može zadati nukleotidnu sekvencu od najmanje 24 nukleotida, identifikator gena ili čak upit u prirodnom jeziku; sistem vraća listu ćelija i prateće informacije o uzorcima u kojima se ta sekvenca pojavljuje.
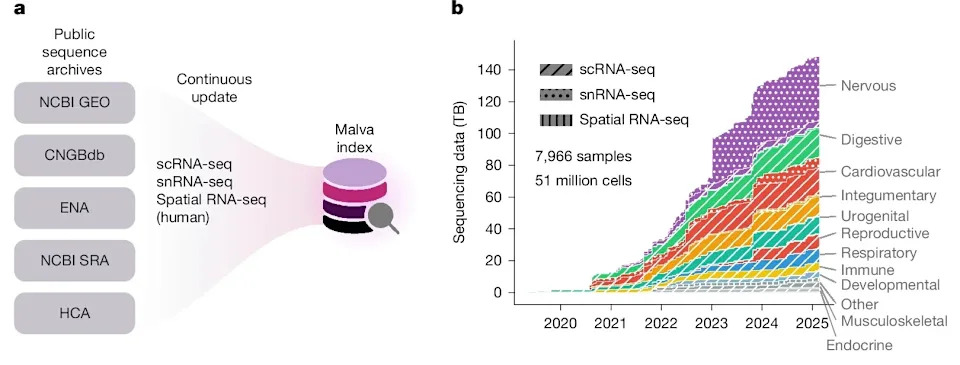
Public sequence archives (NCBI GEO, SRA, ENA, CNGBdb and the HCA data portal) are continuously crawled for single-cell RNA-seq (scRNA-seq), single-nucleus RNA-seq (snRNA-seq) and spatial RNA-seq datasets, which are indexed and integrated into Malva Index. (CREDIT: Nikolaus Rajewsky et al, Nature)
Obim i performanse
Malva Indeks je izgrađen obrađujući više od 140 TB javnih podataka. Ljudski indeks sadrži više od 100 milijardi jedinstvenih 24-nt sekvenci iz oko 51 miliona ljudskih ćelija (592 studije, 7.966 uzoraka), uz dodatnih ~10 miliona mišjih ćelija. U testovima je pojedinačna pretraga po jednom k-meru trajala ~70 ms, pretraga 1.000-baznog transkripta ~0,9 s, a 1.000 transkripata ~1 min na jednoj CPU jezgri.
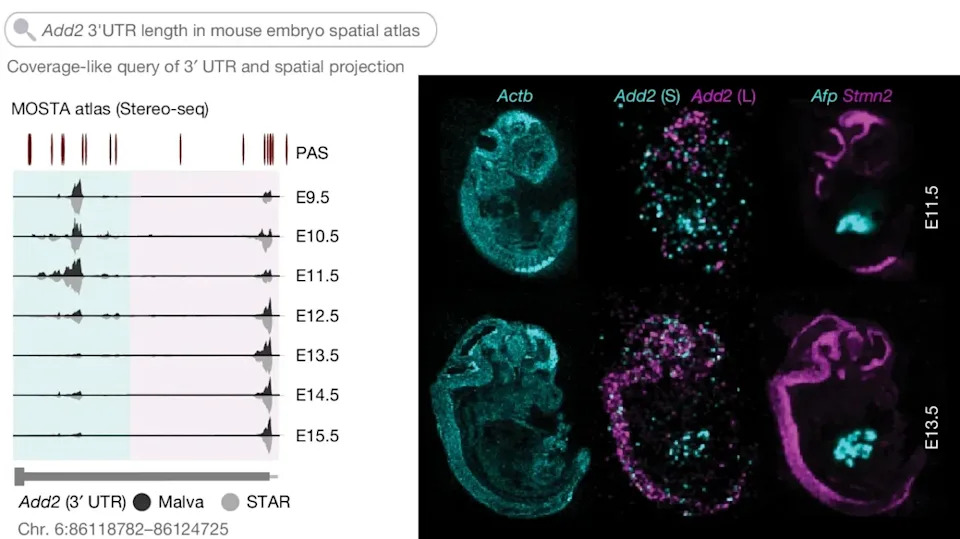
Malva analysis explains 3′ UTR usage patterns in its spatial context—that is, 3′ UTR length regulation of Add2 during spatiotemporal mouse embryogenesis. (CREDIT: Nikolaus Rajewsky et al, Nature)
Šta se može pronaći
Malva omogućava detekciju širokog spektra sekvenci koje često promaknu standardnim gene-centric atlasima, uključujući:
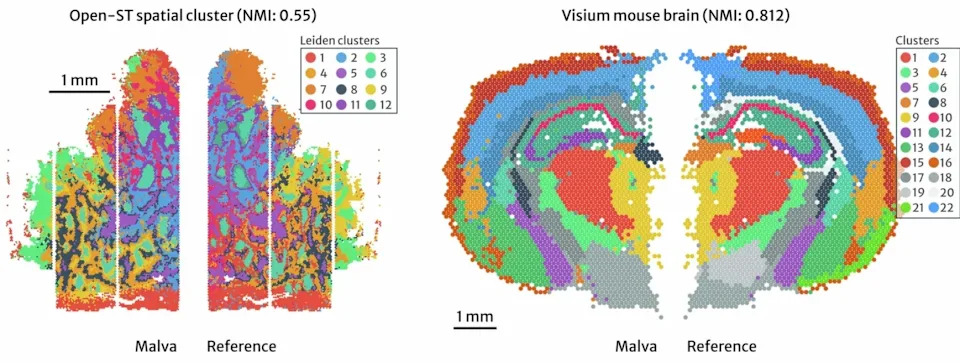
Comparison of cluster results for Open-ST human tumor and Visium mouse brain datasets. Malva-based clustering (left) and reference clustering (right) yield similar structures; spatial coordinates are mirrored for visualization. (CREDIT: Nikolaus Rajewsky et al, Nature)
- Somatičke i nasljedne mutacije
- RNA izoforme i spojne tačke (splice junctions)
- Virusne, bakterijske i gljivične sekvence
- Cirkularne RNA (npr. CDR1as) i druge neklasične transkripte
Autori su pokazali da Malva može da pronađe kontaminante (PhiX, Mycoplasma), prati populacione frekvencije varijanti i otkriva somatičke mutacije u podacima o raku iz 16 tipova tumora bez potrebe za realajnomsirom čitanja.
Prostor i klasterovanje
Platforma podržava i prostornu transkriptomiku, pa je moguće mapirati pojavu specifičnih sekvenci unutar preseka tkiva. Takođe, tim je demonstrirao da se ćelije mogu grupisati na osnovu sekvencijalnog sastava, nezavisno od unapred definisanih gena — što može otkriti mikrobiološke signale u tumorskom okruženju ili neočekivane ćelijske populacije.
Ograničenja i napomene
Važno je razumeti ograničenja: Malva traži upite duže od 24 nukleotida i koristi tačno podudaranje sekvenci. Izveštava k-mer pseudobrojeve, a ne apsolutne molekulske brojeve, pa su dodatne validacije često potrebne. Javne baze su heterogene — mnoga istraživanja koriste kratka čitanja, a prostorne informacije nisu uvek potpune.
Dostupnost i budućnost
Malva je već dostupna akademskim korisnicima preko javnog interfejsa i API-ja. Tim radi na osnivanju kompanije i ima patent u postupku podnošenja. Autori ističu i potencijalnu primenu u kombinaciji sa AI alatima, koji bi mogli brzo proveravati eksperimentalne dokaze iz ogromnih transkriptomskih arhiva.
Zaključak: Malva pretvara velike, statične transkriptomske arhive u dinamičan i pretraživ resurs koji omogućava nove vrste analiza na nivou sekvence — ubrzavajući istraživanja u onkologiji, infektivnim bolestima i osnovnoj biologiji RNA.
Pomozite nam da budemo bolji.